
Reducir el coste de una aplicación de inteligencia artificial no empieza necesariamente por negociar un precio menor por token. La primera pregunta es más básica: ¿cada paso del proceso necesita realmente un modelo? Validar un correo, comprobar un rango numérico, aplicar una plantilla o decidir si un campo está vacío son tareas con reglas claras. Enviarlas a un modelo añade coste, demora y variabilidad sin aportar necesariamente más valor.
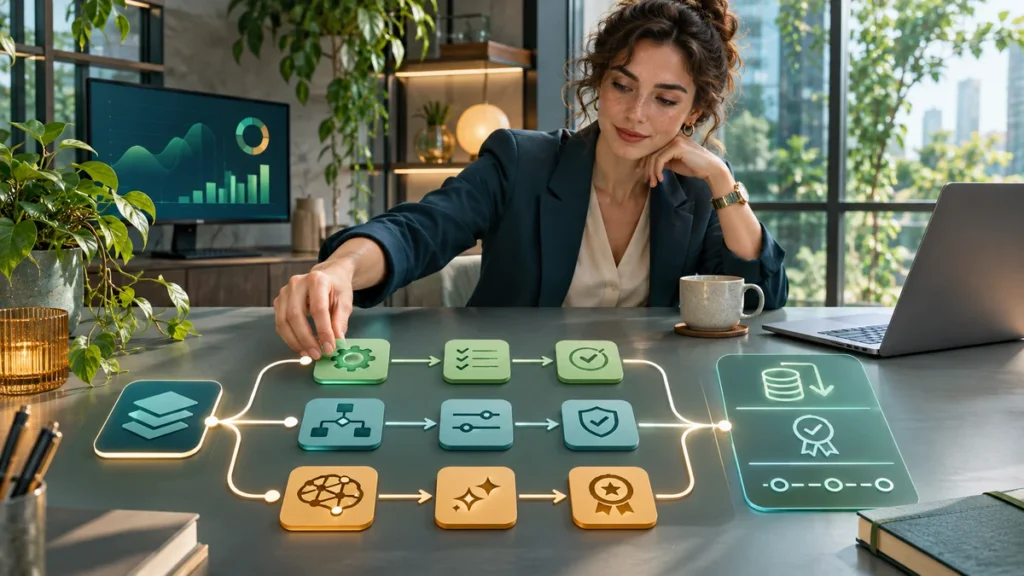
AWS publicó el 17 de noviembre de 2026 una guía que propone dividir los flujos en tres grupos: código determinista para reglas comprobables, llamadas de decisión restringida para elecciones cerradas y modelos generativos ajustados al nivel de calidad necesario para tareas abiertas. El enfoque resulta útil más allá de un proveedor concreto porque obliga a medir el coste por resultado correcto, no solo el precio de cada llamada.
El error de convertir todo el flujo en una llamada al modelo
Cuando una demostración funciona, es tentador enviar al mismo modelo la validación de entrada, la clasificación, la redacción y el formato final. La arquitectura parece sencilla, pero mezcla tareas de naturaleza diferente. Una regla de negocio estable no necesita creatividad. Si el campo «correo» debe contener una estructura válida o un importe debe estar entre dos límites conocidos, el criterio puede expresarse y probarse con código.
La guía técnica de AWS sobre reglas, decisiones y modelos compara ambos caminos. El código determinista suele responder en milisegundos, permanece estable hasta que alguien lo modifica y deja la regla visible en el control de versiones. Una llamada al modelo puede tardar más, se factura según el uso y conserva un margen de error incluso cuando la instrucción parece inequívoca.
Esto no convierte el código tradicional en una solución universal. Resumir un informe, interpretar una consulta ambigua o redactar una respuesta adaptada al contexto sí exige trabajar con lenguaje y juicio. La cuestión consiste en reservar esa capacidad para el punto donde aporta algo que una condición explícita no puede ofrecer.
Tres carriles: regla, decisión cerrada y tarea abierta
1. Código para reglas verificables
Una tarea pertenece al primer carril cuando puede escribirse una prueba de aceptación exacta. Comprobar un formato, convertir una fecha confirmada, eliminar espacios, aplicar una fórmula o rechazar un archivo demasiado grande son ejemplos habituales. La salida correcta no depende de una interpretación creativa.
Trasladar estas operaciones a código reduce el número de tokens procesados y evita respuestas distintas ante la misma entrada. También facilita la auditoría: el equipo puede mostrar qué regla se aplicó y cuándo cambió. La limitación es igualmente clara: una regla solo resuelve los casos que sus autores definieron. Si la realidad contiene excepciones no previstas, el sistema debe detectarlas y derivarlas, no improvisar una corrección silenciosa.
2. Decisiones restringidas para opciones conocidas
Algunas tareas no se reducen a una condición simple, pero tampoco requieren una respuesta libre. Clasificar una solicitud entre cinco departamentos, elegir una categoría de incidencia o decidir si un texto necesita revisión puede tratarse como una selección cerrada. El modelo recibe las opciones permitidas y debe devolver una estructura validable.
Este segundo carril necesita umbrales y escalado. Si la confianza es insuficiente, faltan datos o varias opciones resultan plausibles, la salida adecuada puede ser «revisión humana». Obligar al sistema a escoger siempre una categoría crea una apariencia de automatización completa a costa de errores difíciles de detectar.
3. Modelos para lenguaje, ambigüedad y generación
El tercer carril incluye resúmenes, borradores, explicación de documentos o extracción de significado en texto libre. Aquí tiene sentido utilizar un modelo, pero no necesariamente el más grande disponible. El objetivo es encontrar la opción más económica y rápida que supere un umbral de calidad definido con ejemplos reales.
Un modelo mayor puede mejorar determinadas tareas complejas, pero también puede añadir coste y latencia sin producir una diferencia útil en una clasificación sencilla. Comparar modelos solo con pruebas generales oculta esta realidad. La evaluación debe reproducir el trabajo concreto, sus idiomas, excepciones y criterios de aceptación.
Define la calidad antes de intentar ahorrar
Reducir gasto sin establecer un mínimo de calidad puede trasladar el coste a correcciones, reclamaciones o trabajo manual. Antes de probar alternativas, crea un conjunto de evaluación con entradas representativas y respuestas aceptables. Incluye casos normales, límites, datos incompletos y ejemplos que antes provocaron fallos.
Para cada tarea conviene fijar cuatro límites:
- Calidad mínima: porcentaje de casos que deben superar la revisión o criterios que nunca pueden incumplirse.
- Coste máximo: gasto permitido por solicitud y, mejor aún, por resultado correcto.
- Latencia objetivo: tiempo que puede esperar el usuario, medido también en percentiles altos y no solo como promedio.
- Restricciones: residencia de datos, trazabilidad, permisos y otros requisitos que descartan opciones aunque sean baratas.
La guía de indicadores para evaluar una automatización con inteligencia artificial ayuda a separar volumen, exactitud, tiempo ahorrado y excepciones. Si solo se observa el coste de la API, una solución puede parecer eficiente mientras obliga a rehacer una parte considerable de sus resultados.
Calcula el coste por resultado útil
Supongamos dos configuraciones ficticias. La opción A cuesta 0,02 euros por solicitud y entrega una respuesta válida en el 90 % de los casos. La opción B cuesta 0,01 euros, pero solo alcanza el 60 %. El precio por llamada favorece a B; el coste por resultado válido es aproximadamente 0,0167 euros, frente a 0,0222 euros en A. La diferencia se estrecha antes de añadir el coste de revisar el 40 % restante.
El cálculo real debe incorporar entrada, salida, reintentos, herramientas, almacenamiento, observabilidad y tiempo humano. También puede haber costes por picos de capacidad o por mantener infraestructura reservada. La guía para calcular el coste real de una automatización en una pyme ofrece una estructura para reunir esos elementos sin confundir facturación técnica con rentabilidad.
Etiqueta cada llamada por tarea, versión y resultado. Así podrás descubrir que una operación aparentemente pequeña concentra gran parte del gasto porque se ejecuta miles de veces, o que un paso barato genera demasiadas correcciones. Sin esa trazabilidad, cambiar de modelo puede producir una reducción global mínima.
La caché ayuda cuando el contexto se repite
Muchos flujos envían una y otra vez las mismas instrucciones, herramientas o documentos de referencia. La caché de prompts intenta reutilizar esa parte estable para reducir el procesamiento repetido. La documentación oficial de caché de Amazon Bedrock distingue mecanismos implícitos y explícitos, con compatibilidad y condiciones que dependen del modelo y la API.
La caché no equivale a un ahorro automático. Los prefijos deben permanecer estables y una solicitud elegible no garantiza siempre un acierto de caché. Las escrituras y lecturas pueden tener tarifas distintas. Además, el contenido dinámico situado demasiado pronto en el prompt reduce las coincidencias. La optimización debe medirse con la tasa real de aciertos y la factura correspondiente.
Una estructura práctica coloca primero instrucciones y referencias comunes y deja al final los datos específicos de cada solicitud, siempre que el modelo y la política de seguridad lo permitan. Si el contexto cambia en cada interacción, la caché aportará poco y será preferible buscar otras mejoras.
Compara precios con la unidad correcta
Las páginas de precios suelen separar tokens de entrada, salida, lectura de caché, escritura de caché, lotes y niveles de servicio. La tabla oficial de precios de Amazon Bedrock muestra que las tarifas varían según modelo, región, modalidad y modalidad de ejecución. Por eso no existe un precio único que pueda aplicarse a cualquier arquitectura.
Para comparar, mide una muestra del flujo real: longitud de las instrucciones, contexto recuperado, respuesta, número de herramientas y reintentos. Una tarifa de salida más alta puede importar poco si la respuesta es breve, mientras que un contexto enorme puede dominar el coste de entrada. Actualiza el cálculo cuando cambie el modelo, la región o la política de precios.
No publiques cifras económicas como si fueran permanentes. Registra la fecha, la moneda, la región y el nivel consultado. En este artículo se evita convertir una tarifa puntual en recomendación general porque los precios y la disponibilidad pueden variar.
Un ejemplo: clasificar y responder solicitudes de clientes
Imagina un buzón que recibe consultas sobre facturas, entregas, devoluciones y dudas generales. Una arquitectura que envía cada mensaje completo a un modelo grande para validar, clasificar, recuperar datos y redactar puede funcionar, pero no separa responsabilidades.
- El código valida tamaño, tipo de archivo y campos obligatorios.
- Una decisión restringida clasifica el asunto entre categorías permitidas y deriva los casos dudosos.
- Las reglas consultan plazos o estados exactos en el sistema autorizado.
- Un modelo ajustado redacta una respuesta usando únicamente los datos recuperados.
- El código comprueba formato, referencias obligatorias y ausencia de campos vacíos antes del envío.
El modelo se utiliza donde aporta comprensión y redacción. Las operaciones exactas permanecen visibles y comprobables. Si una política cambia, se actualiza la regla correspondiente sin depender de que un modelo interprete de nuevo un texto ambiguo.
Cómo probar el cambio sin romper el servicio
No sustituyas todos los pasos a la vez. Empieza por instrumentar el flujo actual y crea una línea base de calidad, coste y latencia. Después mueve una regla comprobable a código y ejecuta ambas versiones sobre las mismas entradas. Revisa especialmente las excepciones.
Cuando pruebes un modelo menor, utiliza el mismo conjunto de evaluación y registra no solo la coincidencia con una respuesta de referencia, sino también errores graves, necesidad de revisión y tiempo total. Un promedio alto puede esconder fallos inaceptables en casos poco frecuentes.
Los equipos que necesitan ordenar instrucciones y ejemplos pueden consultar el análisis de la Guía IA para Freelancers. Para profundizar en la formulación de criterios y peticiones, también está el análisis de El arte del Prompting con ChatGPT. Son contenidos comerciales del blog; no sustituyen la medición técnica ni garantizan un ahorro concreto.
Señales de que la optimización está empeorando el sistema
- El coste por llamada baja, pero aumentan los reintentos o las correcciones manuales.
- La latencia media mejora, mientras los casos lentos empeoran.
- Una regla reduce flexibilidad y empieza a rechazar entradas válidas.
- La tasa de aciertos de caché es baja o las escrituras cuestan más de lo que ahorran.
- El modelo pequeño supera las pruebas fáciles, pero falla en excepciones relevantes.
- El equipo no puede relacionar el gasto con una tarea y un resultado verificable.
Si aparece una de estas señales, vuelve a la línea base y revisa la unidad de medida. La optimización correcta no es la que produce la factura mínima aislada, sino la que conserva el nivel de servicio con menor coste total y riesgos controlados.
Conclusión
Reducir el coste de una aplicación de inteligencia artificial exige decidir dónde hace falta inteligencia generativa y dónde basta una regla. El código es apropiado para condiciones exactas; las decisiones cerradas necesitan opciones validadas y escalado; las tareas abiertas justifican un modelo ajustado a una calidad mínima comprobada.
Después llegan la selección de modelo, la caché y las tarifas. Ninguna de esas técnicas debe evaluarse solo por el precio nominal. Mide coste por resultado correcto, latencia, revisión humana y errores. La mejor arquitectura no utiliza el modelo más potente en cada paso: utiliza la herramienta más sencilla que cumple el requisito y deja evidencia suficiente para saber cuándo deja de cumplirlo.