
Microsoft ha presentado Maia 300 como la tercera generación de su sistema de aceleración para inteligencia artificial y ha situado su despliegue en producción en 2027. El anuncio llega acompañado de cifras enormes: 96 aceleradores por rack, 167 kilovatios por rack, hasta 12.288 aceleradores por superpod y despliegues que, en conjunto, alcanzarán varios gigavatios. Sin contexto, estos números pueden parecer únicamente una nueva carrera por construir centros de datos más grandes. La cuestión útil es otra: ¿qué cambia realmente para ejecutar modelos y agentes de inteligencia artificial?
La respuesta corta es que Maia 300 no se presenta como un chip genérico para entrenar cualquier modelo, sino como un sistema diseñado de extremo a extremo para la inferencia: el trabajo que se realiza cuando un modelo ya entrenado responde, mantiene un contexto largo, usa herramientas o completa una tarea de varios pasos. Microsoft afirma que esa especialización permitirá producir más tokens por cada vatio disponible y aumentar la capacidad de servicios como Copilot, GitHub Copilot y Microsoft Foundry.
Para separar arquitectura, promesa comercial y efecto práctico, conviene hacer tres comprobaciones: qué mide Microsoft cuando habla de rendimiento; cómo encajan energía, memoria y red dentro de un rack; y qué significa en realidad anunciar despliegues multigigavatio.
Respuesta rápida: qué es Microsoft Maia 300
Microsoft Maia 300 es un acelerador y, al mismo tiempo, la pieza central de un sistema completo de inferencia en Azure. Combina silicio, memoria HBM4, una arquitectura de chiplets, red basada en Ethernet, refrigeración líquida, software de flujo de datos y racks de alta densidad. Está optimizado para cargas con contexto largo, razonamiento, decodificación intensiva y agentes que ejecutan varios pasos.
No debe confundirse con un ordenador personal, una GPU que el usuario pueda comprar ni un nuevo modelo de inteligencia artificial. Tampoco estará disponible de inmediato: Microsoft señala que los primeros despliegues de producción de Maia 300 comenzarán en 2027. Durante 2026, Maia 200 ya sirve cargas internas, entre ellas Microsoft Copilot, y prepara su llegada a GitHub Copilot y Microsoft Foundry.
| Dato anunciado | Maia 300 | Qué permite interpretar |
|---|---|---|
| Memoria por acelerador | 288 GB HBM4 | Más estado del modelo y caché de contexto cerca del cálculo |
| Ancho de banda de memoria | 18 TB/s por acelerador | Reduce esperas en cargas limitadas por movimiento de datos |
| Potencia del acelerador | 950 W TDP | Obliga a evaluar rendimiento por vatio, no solo potencia bruta |
| Configuración del rack | 96 aceleradores, 167 kW | Alta densidad con energía, red y refrigeración codiseñadas |
| Superpod | Hasta 12.288 aceleradores | Una misma carga puede extenderse por numerosos racks |
| Inicio previsto | 2027 | Es una hoja de ruta de producción, no disponibilidad actual |
Primera comprobación: 7× por rack no significa 7× en cualquier tarea
La cifra más llamativa del anuncio es que una configuración completa de 96 aceleradores puede ofrecer hasta siete veces más rendimiento de tokens por rack que Maia 200. Microsoft también habla de más de 2,5 veces el rendimiento por vatio frente a la generación anterior y de un 40 % más de tokens por megavatio frente a sistemas líderes basados en GPU.
Las palabras «hasta» y «tokens» importan. Un token es una unidad de procesamiento de texto o código, pero la velocidad observada depende del modelo, la longitud del contexto, la precisión numérica, el tamaño del lote, la red y el reparto entre la fase inicial de lectura y la generación posterior. Una mejora medida en inferencia de gran escala no equivale automáticamente a que cada conversación individual responda siete veces más rápido.
La comparación también mezcla cambios de varias capas. Maia 300 duplica el número de aceleradores por rack respecto a Maia 200, aumenta el ancho de banda de memoria, utiliza nuevos formatos de baja precisión y cambia la organización interna de los datos. Por eso, el salto no puede atribuirse solo al chip. Es el resultado del rack completo y de su software.
El enfoque tiene sentido porque mover datos consume tiempo y energía. En una inferencia con contexto largo, no basta con multiplicar matrices deprisa: el sistema debe alimentar continuamente los núcleos de cálculo, conservar la caché de claves y valores y comunicar distintos fragmentos del modelo. El propio análisis técnico de Azure identifica ese movimiento como uno de los principales cuellos de botella. Esta idea conecta con nuestro análisis sobre por qué los datos y su infraestructura limitan muchos proyectos de inteligencia artificial empresarial.
Precisión reducida y contexto largo
Maia 300 incorpora formatos como MXFP4 mejorado y almacenamiento por debajo de cuatro bits para reducir memoria y tráfico. La ventaja potencial es clara: si cada peso o fragmento de caché ocupa menos, caben modelos mayores, más sesiones simultáneas o ventanas de contexto más largas dentro del mismo presupuesto energético.
Pero reducir precisión exige calibración. Un formato compacto puede funcionar muy bien en unas capas y perjudicar otras. Microsoft no ha publicado en el anuncio resultados completos de calidad para cada modelo ni una tabla independiente que permita comparar todas las cargas con GPU rivales. Por tanto, las cifras deben leerse como especificaciones y proyecciones del fabricante, no como una clasificación universal.
Segunda comprobación: el rack es la unidad útil, no el chip aislado
Cada acelerador Maia 300 integra ocho pilas HBM4, 288 GB de capacidad y un ancho de banda máximo de 18 TB/s dentro de un TDP de 950 vatios. Su arquitectura separa cálculo, controladores de memoria y entrada/salida en varios chiplets. Los chiplets de cálculo se fabrican en el proceso N2P de TSMC, mientras otras funciones pueden usar tecnologías más adecuadas para ancho de banda, conectividad o coste.
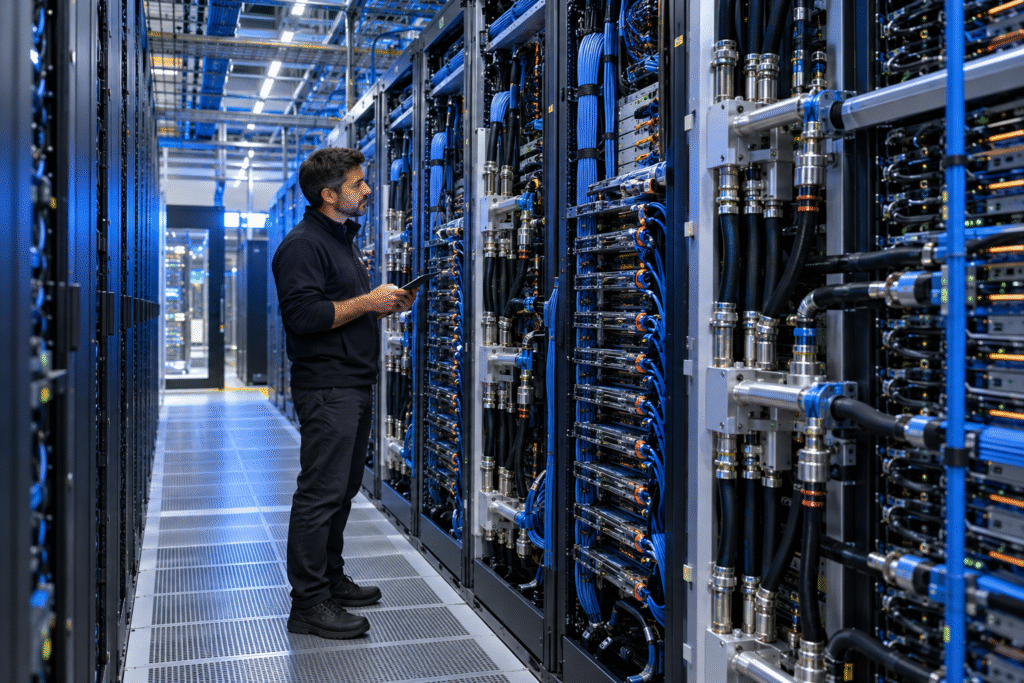
El rack agrupa 96 aceleradores en 24 bandejas de cuatro unidades y consume 167 kW. A esa escala, la electricidad destinada al silicio no es el único factor: también cuentan los servidores anfitriones, los conmutadores, las pérdidas de distribución y la refrigeración. Microsoft afirma que la refrigeración líquida extrae más del 80 % de la carga térmica del rack, aunque mantiene aire para memoria, almacenamiento y otros componentes.
La red tampoco es un accesorio. Dentro del rack se combinan enlaces directos y rutas conmutadas; entre racks aparece una segunda capa óptica. Hasta 128 racks pueden formar un superpod de 12.288 aceleradores. El objetivo es que el software vea una misma estructura de comunicación y pueda situar el tráfico más sensible a la latencia en los dominios cercanos.
Esta escala es radicalmente distinta de ejecutar un modelo en local. Equipos compactos como el analizado en NVIDIA DGX Spark y sus 64 GB para agentes locales priorizan autonomía, privacidad y experimentación individual. Maia 300 busca servir millones de interacciones, mantener modelos enormes y repartir tareas entre racks. Son herramientas para problemas diferentes, no sustitutos directos.
Por qué la memoria pesa tanto
En modelos generativos, el cálculo inicial del prompt —prefill— y la generación token a token —decode— tienen perfiles distintos. Maia 300 permite dimensionar y colocar de forma separada los trabajadores dedicados a cada fase. Después del prefill, el estado de la conversación puede pasar directamente a los nodos de decodificación dentro de la misma red de escala.
Esta separación ayuda a evitar que una parte del sistema espere innecesariamente a otra. También permite adaptar recursos a servicios muy diferentes: una respuesta breve de un asistente, una revisión de repositorios de código o un agente que mantiene contexto durante horas. La promesa no es solo producir más tokens, sino usar mejor la capacidad disponible.
Tercera comprobación: «multigigavatio» describe escala de infraestructura
Microsoft afirma que la familia Maia se ampliará a despliegues multigigavatio a partir de 2027 y que se convertirá en el sistema principal de inferencia para sus productos y servicios. Un gigavatio equivale a mil megavatios. Como un rack Maia 300 se sitúa en 167 kW, un gigavatio teórico de potencia de racks equivaldría aproximadamente a 5.988 racks, antes de considerar el resto del centro de datos.
Esa división sirve para comprender el orden de magnitud, pero no debe presentarse como un plan exacto. Microsoft no ha detallado cuántos gigavatios corresponderán exclusivamente a Maia 300, en cuántas regiones se repartirán ni durante qué calendario se incorporará cada instalación. «Multigigavatio» es una estrategia agregada de capacidad, no la ficha de una única planta.
La consecuencia empresarial es doble. Por un lado, fabricar aceleradores propios reduce la dependencia de un solo proveedor y permite ajustar costes a cargas internas muy conocidas. Por otro, aumenta el compromiso de Microsoft con una infraestructura específica: debe garantizar suministro de memoria, fabricación avanzada, redes, agua, electricidad y software capaz de aprovecharla.
La eficiencia por vatio no elimina el consumo total. Un sistema puede ser mucho más eficiente por token y, aun así, usar más electricidad si la demanda crece todavía más deprisa. Por eso, para evaluar el impacto ambiental serían necesarios datos de utilización real, mezcla energética, consumo de agua, ciclo de vida del hardware y emisiones por unidad de trabajo útil. El anuncio técnico no ofrece todavía ese cuadro completo.
¿Qué servicios podrían cambiar primero?
Microsoft cita cuatro grandes destinos. Copilot ya utiliza Maia 200; GitHub Copilot y Microsoft Foundry deberían incorporarlo antes de terminar 2026. Maia 300 está pensado para ampliar ese camino en 2027 y atender razonamiento con contexto largo, conversaciones sensibles a la latencia, generación de datos y agentes de varios pasos. También se menciona Dragon Copilot en sanidad.
Para el usuario, el efecto puede aparecer como mayor disponibilidad, respuestas más largas, menor latencia en horas punta o funciones agentivas que antes resultaban demasiado caras. No obstante, disponer de más infraestructura no garantiza por sí solo un mejor producto. La calidad seguirá dependiendo del modelo, los datos, las evaluaciones, la seguridad y el diseño de la experiencia.
Lo mismo ocurre con la automatización profesional. Una infraestructura más potente puede sostener más agentes, pero todavía hay que definir permisos, registros, límites y recuperación ante fallos. Quien quiera empezar en una escala mucho más pequeña puede revisar nuestra guía comercial sobre automatización local con n8n o el análisis del ebook Domina N8N desde Cero. Son recursos internos con enfoque práctico; este artículo no enlaza directamente a sus plataformas afiliadas.
Qué sabemos y qué falta por demostrar
- Confirmado: Maia 200 ya atiende cargas de producción de Microsoft y Maia 300 tiene despliegue previsto para 2027.
- Confirmado por Microsoft: 288 GB HBM4, 18 TB/s, 950 W por acelerador y 96 aceleradores dentro de un rack de 167 kW.
- Comparación del fabricante: hasta 7× más tokens por rack y más de 2,5× rendimiento por vatio frente a Maia 200.
- Expectativa del fabricante: 40 % más tokens por megavatio que sistemas GPU líderes.
- No publicado todavía: precios de Azure, disponibilidad para clientes, catálogo exacto de modelos, resultados independientes y consumo real por servicio.
- Inferencia razonable: el control conjunto de chip, red, software y productos puede mejorar costes y utilización, pero el resultado dependerá de cada carga.
Tres preguntas antes de interpretar cualquier anuncio de hardware para IA
- ¿Qué se está midiendo? No es lo mismo latencia de una conversación, tokens totales por rack, coste por millón de tokens o rendimiento durante el entrenamiento.
- ¿Contra qué se compara? Maia 300 se compara unas veces con Maia 200 y otras con sistemas GPU líderes. Sin configuración, modelo y precisión, las cifras no son intercambiables.
- ¿Está disponible o es una hoja de ruta? Maia 200 está en producción; Maia 300 comenzará a desplegarse en 2027. La diferencia temporal es esencial.
Preguntas frecuentes sobre Microsoft Maia 300
¿Maia 300 es una GPU?
Es un acelerador especializado para inteligencia artificial dentro de un sistema completo de Azure. Comparte algunas funciones con una GPU para centros de datos, pero su arquitectura y software están orientados específicamente a inferencia de modelos generativos y agentes.
¿Se podrá comprar para un ordenador?
Microsoft no ha anunciado una versión de consumo. Maia 300 está diseñado para racks y centros de datos de Azure, con redes, energía y refrigeración propias de infraestructura a gran escala.
¿Entrenará modelos nuevos?
El diseño se describe como «inference-first». Microsoft contempla inferencia y generación de datos para sus equipos de modelos, pero el anuncio no lo presenta como sustituto universal de los grandes sistemas de entrenamiento.
¿Cuándo llegará a producción?
Microsoft prevé iniciar los despliegues de producción en 2027. No ha publicado una fecha concreta de disponibilidad comercial para clientes de Azure.
¿Por qué importan los tokens por megavatio?
Porque la potencia eléctrica y la refrigeración limitan cuánta capacidad puede instalarse en un centro de datos. Producir más tokens útiles dentro del mismo presupuesto energético puede reducir costes y ampliar el número de usuarios atendidos.
Conclusión
Maia 300 muestra que la competición de inteligencia artificial ya no se decide únicamente en el modelo. También se juega en la memoria, el movimiento de datos, la red, la refrigeración y la capacidad de operar miles de aceleradores como un solo sistema.
Las tres cifras más útiles son 18 TB/s por acelerador, 96 aceleradores por rack y el inicio de despliegues en 2027. Juntas explican la apuesta: Microsoft quiere optimizar la inferencia de agentes y contextos largos a escala masiva. Las cifras de rendimiento son ambiciosas, pero todavía proceden del fabricante y necesitan validación en servicios, modelos y costes reales. Esa separación entre especificación, proyección y experiencia de usuario es la clave para entender el anuncio sin convertirlo en propaganda ni minimizar su alcance.
Fuentes primarias
- Microsoft: expansión del sistema Azure Maia a despliegues multigigavatio, 12 de octubre de 2026.
- Azure: análisis técnico de la arquitectura Maia 300, 12 de octubre de 2026.
- Microsoft Source: materiales y recursos de Maia 300, 12 de octubre de 2026.